Les 5 murs entre un benchmark HTTP à 3M req/s et la production
🇬🇧ENUn framework à 3M req/s ne tient jamais ce chiffre en production. Les 5 murs qui font fondre le débit, mesurés sur HTTP Arena : JSON, TLS, base de données, cloud.
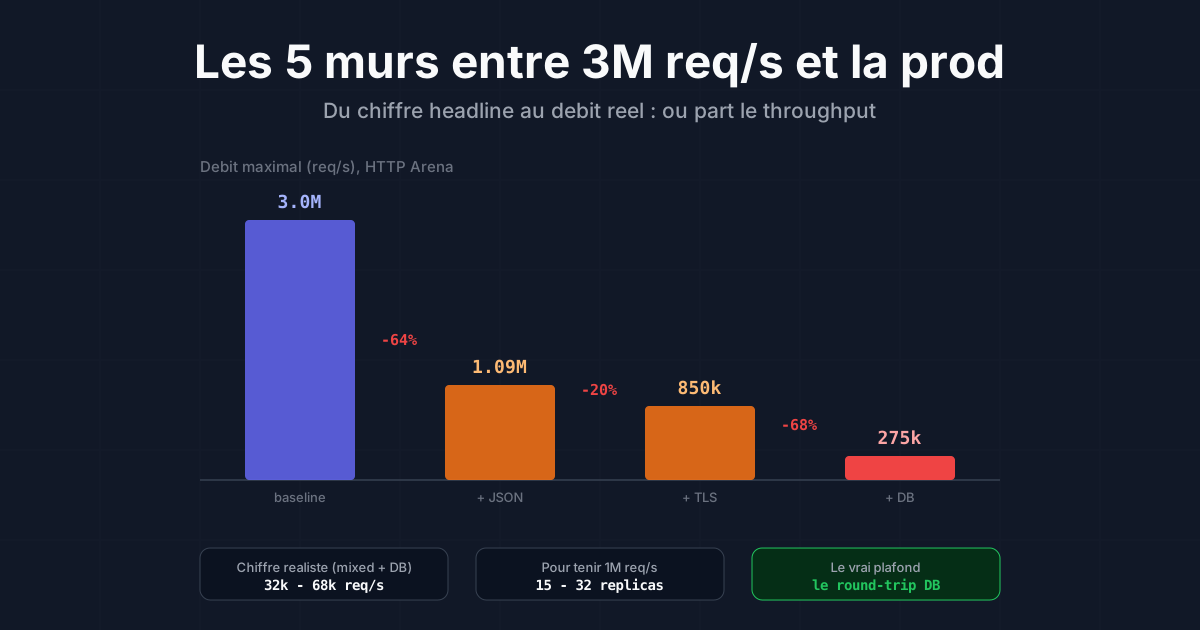
Un framework HTTP annoncé à 3 millions de requêtes par seconde ne sert jamais 3 millions de requêtes par seconde en production. Le chiffre est réel, la mesure est honnête, mais il décrit un scénario qui n’existe pas : connexions persistantes, réponse statique, aucune base de données, aucun TLS. Dès qu’on ajoute ce qu’un vrai service fait, le débit s’effondre.
Cet article suit ce que devient le chiffre headline à mesure qu’on le confronte au réel. Cinq murs, dans l’ordre, avec les chiffres mesurés sur HTTP Arena, le successeur des TechEmpower Framework Benchmarks archivés en mars 2026.
D’où vient le chiffre headline
HTTP Arena teste 157 entrées sur 30 profils, sur un seul Ryzen Threadripper, en gardant le meilleur de 3 runs. Le fameux « 3M req/s » vient du profil baseline : connexions HTTP persistantes réutilisées, réponse statique de quelques octets, rien d’autre. C’est la mesure du coût de ne rien faire, celui du runtime et de la stack réseau à vide.
Ce profil est utile : il isole la surcharge du framework. Mais personne ne déploie un service qui renvoie une constante sur des connexions déjà ouvertes. Chaque brique qu’on rajoute est un mur.
Mur 1 : la sérialisation JSON
Premier ajout réaliste : renvoyer un vrai body. Le profil qui sérialise 50 objets JSON fait tomber le débit de 3M à 1,09M req/s, une chute d’environ 64%.
La raison est simple : le body n’est plus une constante. Il faut allouer, encoder, et écrire une charge utile qui varie à chaque requête. La sérialisation devient le poste dominant, avant même de parler de réseau chiffré ou de données. C’est le premier rappel que le « fastest framework » d’un tableau mesure surtout la vitesse à ne rien produire.
Mur 2 : TLS
Ajouter le chiffrement fait passer de 1,09M à 850k req/s, environ -20%. C’est le mur le moins cher de la liste, et c’est contre-intuitif : on imagine souvent TLS comme un gouffre de performance.
En réalité, la poignée de main asymétrique coûte cher une fois par connexion, mais le chiffrement symétrique du flux est accéléré matériellement sur les CPU modernes. Sur des connexions persistantes, l’amortissement est bon. TLS n’est pas le problème qu’on croit, à condition de réutiliser les connexions.
Mur 3 : le round-trip base de données
C’est le vrai plafond. Un seul SELECT asynchrone vers Postgres fait chuter le débit de 850k à 275k req/s, environ -68%. Par rapport au baseline, c’est un facteur 11.
Un aller-retour réseau vers la base, même local, même indexé, même sur une seule ligne, coûte plus que tout le reste réuni. Et c’est le plancher : la plupart des services font plusieurs requêtes par appel HTTP, pas une seule.
C’est là que le classement des frameworks s’écrase. Un langage qui menait avec un facteur 31 sur le profil statique retombe à un facteur 6,5 dès qu’une base est dans le chemin. Le coût dominant n’est plus le vôtre, c’est celui de l’I/O. Optimiser le runtime sans optimiser les accès à la base, c’est raboter les 9% qui restent en ignorant les 91% qui comptent. J’ai détaillé les patterns d’accès aux données dans mon article sur l’architecture en couches d’une API Rust/Axum/SQLx.
Mur 4 : les connexions éphémères
Les trois premiers murs supposent des connexions réutilisées. En pratique, une partie du trafic ouvre et ferme une connexion par requête : clients mobiles, proxies mal configurés, appels serveur-à-serveur sans pool. Sur les profils à connexions éphémères, le débit peut chuter jusqu’à -75% de plus.
Le setup et le teardown TCP dominent alors le temps de traitement. C’est le seul mur où io_uring change vraiment la donne : environ 2,5x mieux que l’API socket classique sur ce profil précis. Mais attention au compromis : la même stack io_uring est environ 19% plus lente sur le profil statique. On n’optimise pas pour les deux mondes en même temps ; on choisit la charge qu’on sert.
Mur 5 : le throttle du fournisseur cloud
Le dernier mur n’est pas technique. Même avec un service capable d’encaisser le débit, l’infrastructure managée impose ses propres limites.
Une API Gateway plafonne souvent à 10 000 req/s par défaut, et à 2 500 dans une bonne partie des régions. Et le coût suit la même logique : à 1 million de req/s sur un tier REST facturé à la requête, la facture atteint l’ordre de 6 millions de dollars par mois. Le mur n’est plus le CPU, c’est le quota et le prix. Beaucoup d’architectures « lentes » sur le papier ne butent jamais sur leur runtime : elles butent sur la ligne de facturation avant.
Le chiffre de référence réaliste
Une fois les murs franchis, quel débit attendre d’une entrée bien optimisée ? Sur le profil « mixed » (4 vCPU, 16 Go, avec base de données), les meilleures entrées d’HTTP Arena font 32 000 à 68 000 req/s.
| Profil | Débit des meilleures entrées | Écart au baseline |
|---|---|---|
| Baseline (statique, keep-alive) | 3 000 000 req/s | reference |
| JSON 50 objets | 1 090 000 req/s | -64% |
| + TLS | 850 000 req/s | -72% |
| + 1 SELECT Postgres | 275 000 req/s | -91% |
| Mixed 4 vCPU avec DB | 32 000 - 68 000 req/s | -98% |
La colonne « Écart au baseline » est cumulative ; les pourcentages cités dans le texte des murs sont relatifs à l’étape précédente.
Le passage du chiffre headline au chiffre réaliste, c’est deux ordres de grandeur. Concrètement, pour tenir 1 million de req/s sur un service réel, il faut compter 15 à 32 replicas, soit 60 à 128 vCPUs. Pas un seul process magique.
Le pattern qui marche pour 95% des cas
La conclusion pratique est ennuyeuse, et c’est une bonne nouvelle : scaling horizontal. Des replicas stateless derrière un load balancer L4, un accès base par requête, un cache devant cet accès. Ça passe à l’échelle linéairement, ça se débogue, ça se déploie sans cérémonie.
Le single-box tuné à l’extrême ne se justifie que dans les 5% de cas où le trafic est uniforme et cacheable : enchères publicitaires, télémétrie, lookups statiques à très haut volume. Partout ailleurs, la variabilité du trafic et la présence d’une base rendent l’optimisation micro du runtime marginale. C’est aussi pour ça que je construis mes moteurs applicatifs autour de la robustesse plutôt que du pic de débit, comme dans IronFlow.
Quand le débit brut n’est vraiment pas le problème
Un cas documenté l’illustre bien : l’API Red de Zalando servait plus d’un million de req/s, et le goulot n’était pas le throughput brut mais un proxy partagé dans le hot path. Chaque batch de 100 requêtes traversait le proxy 100 fois.
La solution n’a rien à voir avec un framework plus rapide. L’équipe a déplacé le routage dans le process appelant (un hashring cohérent, 100 nœuds virtuels par endpoint, fade-in de 30 secondes pour les nouveaux pods) et dimensionné la charge avec la loi de Little : concurrence = taux d'arrivée × latence. Résultat : le fleet de proxies est passé de plus de 50 pods à 8, et le coût de 450 à 110 dollars par jour. Le débit n’avait jamais été le mur.
Latence contre débit : le piège de la moyenne
Dernier point, souvent oublié : à haut débit, la latence moyenne ment. Sur le profil TLS d’HTTP Arena, à 1,5M req/s, la latence moyenne est de 19 ms mais le P99 grimpe à 983 ms. Comme l’a formalisé Marc Brooker (AWS) dans son analyse du coût de la traîne, les requêtes au-dessus du P99 portent à elles seules environ la moitié de la latence moyenne totale.
La loi de Little explique le mécanisme : sur le profil TLS, il y a environ 29 000 requêtes en vol à tout instant, contre 600 sur le profil statique. Soit 47 fois plus de concurrence, à un débit pourtant plus bas. Plus la latence monte, plus les requêtes s’empilent, plus la concurrence explose, et plus la traîne coûte cher. Regarder le débit moyen sans regarder la distribution de latence, c’est ne voir qu’une moitié du système.
Ce qu’il faut retenir
Le framework fixe le coût de ne rien faire. C’est utile à connaître, mais ce n’est pas le facteur limitant d’un vrai service. Le round-trip base de données est le vrai plafond, et il écrase les écarts entre langages et frameworks. Un avantage de 31x sur le papier fond à 6,5x dès qu’une requête SQL entre dans le chemin.
Avant d’aller chercher le framework le plus rapide d’un classement, posez la question qui compte : combien d’allers-retours base par requête, et à quel prix chez votre fournisseur ? C’est là que se joue le débit réel, pas dans le profil statique du benchmark.