Pourquoi plus de 30 skills tue ton agent IA
🇬🇧ENAu-delà de ~30 skills, un agent IA choisit de moins en moins le bon outil. Le vrai coupable n'est pas le contexte alourdi mais le mauvais routage. Chiffres, mécanisme, et contre-mesures concrètes.
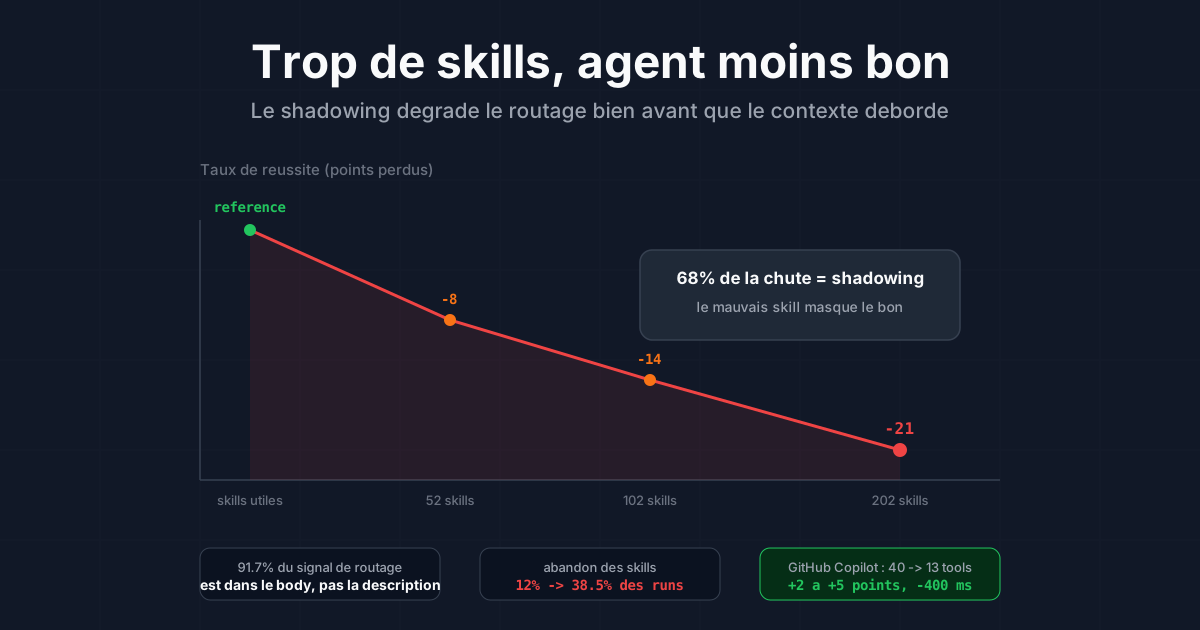
Plus un agent a de skills, mieux il devrait travailler. C’est l’intuition. C’est faux. Au-delà d’une trentaine de skills ou d’outils, ajouter une capacité de plus dégrade souvent l’agent au lieu de l’améliorer. Et le problème n’est pas celui qu’on croit : ce n’est pas le contexte qui gonfle, c’est le routage qui se casse.
J’ai une cinquantaine de skills installés dans ma config Claude Code. Cet article explique pourquoi c’est déjà dans la zone rouge, ce que disent les mesures, et comment reprendre le contrôle.
Le paradoxe, mesuré
Une étude de 2026, More Skills, Worse Agents?, a fait l’expérience proprement : partir d’un jeu de skills utiles à la tâche (l’oracle), puis noyer l’agent sous une bibliothèque de plus en plus grosse, et mesurer le taux de réussite.
| Taille de la bibliothèque | Points de réussite perdus |
|---|---|
| Skills utiles seuls (référence) | 0 |
| 52 skills | -8 |
| 102 skills | -14 |
| 202 skills | -21 |
La chute est monotone et elle n’est pas marginale : 21 points de pass rate entre un agent bien équipé et le même agent noyé sous 202 skills, en moyenne sur deux modèles. Le savoir-faire est identique, les outils nécessaires sont toujours là. Seul le bruit a changé.
Pire signal encore : la proportion de runs où l’agent n’invoque aucun skill et fait le travail à la main passe de 12% (jeu de skills utiles) à 38,5% (202 skills). L’agent ne se trompe pas seulement de skill, il finit par renoncer à en chercher un.
Les trois façons dont un skill de trop dégrade l’agent
Context overhead. Chaque skill ajoute son nom et sa description au prompt de départ. À 200 skills, ça fait du volume, et un prompt plus long dégrade l’inférence. Effet réel mais faible : environ un tiers de la chute, et statistiquement indiscernable de zéro dans l’étude. C’est le suspect évident, et c’est le mauvais.
Shadowing. C’est le vrai coupable. Quand deux skills ont des descriptions proches, le mauvais peut “masquer” le bon parce que sa description colle un peu mieux à la requête. L’agent choisit avec confiance, et il choisit mal. Cet effet domine : jusqu’à 68% de la dégradation, et c’est le seul effet statistiquement significatif. Surtout, il grandit linéairement avec la taille de la bibliothèque. Plus vous ajoutez de skills qui se ressemblent, plus vous fabriquez d’occasions de vous tromper.
Abandon. Le degré ultime du shadowing : l’agent, incapable de trancher, ne choisit rien et fait le travail sans skill. Le tiers des runs à 202 skills. C’est le plus pervers parce qu’il est invisible : dans les logs, “aucun skill invoqué” ressemble à un cas où aucun skill n’était pertinent, pas à un échec de routage.
Le vrai problème : le routeur ne voit que 8% du signal
Pourquoi le routage se trompe autant ? Parce que la décision se prend sur la mauvaise information.
Claude Code charge les skills en trois niveaux, un mécanisme appelé progressive disclosure :
Le routeur ne voit que le niveau 1, le nom et la description, pour décider quel skill charger. Or le papier SkillRouter a mesuré, par analyse d’attention sur un cross-encoder, que 91,7% du signal de routage vit dans le body du skill, celui du niveau 2. Le nom et la description, ceux sur lesquels la décision se prend, ne portent qu’une fraction du signal.
La preuve par l’ablation : retirer le body fait chuter la qualité du routage de 29 à 44 points selon la méthode. Distiller le body en meilleures descriptions récupère une partie du signal, mais jamais tout. On demande au routeur de trancher entre 200 candidats avec 8% de l’information pertinente. Le shadowing n’est pas un bug, c’est la conséquence mathématique de ce design.
Le même papier montre qu’un pipeline retrieve-and-rerank qui lit le body complet atteint 74% de Hit@1 sur une bibliothèque de ~80 000 skills, avec un modèle 13 fois plus petit que l’alternative naïve. Le signal existe. Il faut juste le regarder.
La troncature silencieuse de Claude Code
Il y a un deuxième piège, propre à Claude Code. Les descriptions de skills passent par un budget de caractères, calibré autour de 1% de la fenêtre de contexte. Quand ce budget déborde, Claude Code tronque.
Les conséquences sont vicieuses :
- La troncature coupe la fin de la description, souvent là où vivent les mots-clés de déclenchement. Un skill qui matchait “ouvre une merge request” ne matche plus rien si la phrase est coupée avant.
- Les skills les moins invoqués sont tronqués en premier. Vos skills rares deviennent injoignables, ce qui les rend encore plus rares.
- Installer le skill N+1 peut casser le routage du skill N. Rien dans le skill N n’a changé, mais il a perdu de la place dans le budget partagé.
Autrement dit, chaque skill ajouté n’est pas neutre pour les autres. Vous ne payez pas seulement le context overhead, vous redistribuez un budget fini entre des descriptions qui se disputent la même place. Et une étude publique note que 26,4% des skills publics n’ont aucune description de routage exploitable, ce qui garantit le shadowing dès le départ.
Ce que font ceux qui opèrent à grande échelle
La réponse de l’industrie converge : arrêter de tout exposer d’un coup, et router intelligemment.
| Acteur | Action | Résultat |
|---|---|---|
| GitHub Copilot (nov. 2025) | 40 tools par défaut ramenés à 13, le reste en groupes virtuels chargés à la demande | +2 à +5 points de réussite, -400 ms de latence |
| Anthropic (nov. 2025) | Tool Search Tool : Claude découvre les outils dynamiquement au lieu de tout charger | Opus 4.5 : précision d’usage d’outils de 79,5 à 88,1 |
GitHub a documenté comment réduire l’outillage par défaut a amélioré SWE-bench et SWE-Lancer sur GPT-5 comme sur Sonnet 4.5. Leur constat tient en une phrase : donner plus d’outils à un agent ne le rend pas plus intelligent, juste plus lent.
Anthropic va dans le même sens avec le Tool Search Tool : au lieu de charger les 200 définitions d’outils dans le contexte, Claude cherche l’outil pertinent à la demande. C’est le même principe que le proxy MCP RTK dont j’ai parlé ici : ne pas payer en tokens et en confusion ce qu’on n’utilise pas.
Contre-mesures concrètes
| Approche | Effort | Preuve |
|---|---|---|
| Réduire le nombre de skills actifs | Faible | GitHub : -27 tools = +2 à +5 points |
| Passer au routage à la demande (search-based) | Moyen | Anthropic : +8,6 points sur Opus 4.5 |
| Router sur le body complet (encoder + re-ranker) | Élevé | SkillRouter : 74% top-1 sur 80k skills |
En pratique, dans ma config Claude Code, trois actions donnent le meilleur rapport effort/gain :
Auditer les descriptions. Vérifier qu’aucun skill critique n’a sa description tronquée, et que les mots-clés de déclenchement sont au début, pas à la fin. Une description qui commence par ses triggers survit à la troncature.
Consolider les skills à triggers proches. J’avais des variantes qa-swarm par projet (une par repo), avec des descriptions quasi identiques. C’est un cas d’école de shadowing : quatre skills qui se disputent la même requête. Les fusionner en un skill paramétré supprime quatre occasions de mal router. C’est exactement le travail que j’ai décrit dans mon article sur les skills efficaces : une description doit dire quand se déclencher, pas seulement ce que le skill fait.
Mesurer, pas deviner. Comparer le taux de match correct avec le set complet contre un set réduit aux 15 skills les plus utilisés. Si le set réduit route mieux, vous avez votre réponse : la moitié de vos skills coûte plus qu’elle ne rapporte.
Le seuil, en pratique
La dégradation devient mesurable à partir de ~30-50 skills. En dessous, le shadowing existe mais reste absorbé par la marge du modèle. Au-delà, chaque ajout se paye deux fois : une fois en tokens, une fois en occasions de mal router.
La règle que j’applique maintenant : un skill n’entre dans ma config que si sa description ne peut déclencher que lui. Si je peux imaginer une requête où il entrerait en concurrence avec un skill existant, soit je fusionne, soit je réécris les deux descriptions pour les rendre disjointes. Un skill de plus n’est jamais gratuit. C’est un pari sur le routeur, et le routeur ne voit que 8% du tableau.